本文的标题本来计划作为自今年三月起的一项工作的论文题目,但遗憾最终文章没能问世。我们在 idea 评估这个议题上做了一些的尝试和探索,尽管因为一些因素终止了这个项目,但仍然期望整理出这个过程中的一些思考,为这个周期的努力留有一些公开的痕迹,也期望如果可能的话,能够为这个领域带来一些微末的启发。
chapter 1
在 2026 年 10 月份的当下,auto research 在领域内已经具有相当的热度,甚至开始滥用。截至 9 月,ICLR 2027 的 abstract 注册数突破了 6 万篇 [1],而一年前的有效投稿还不到 2 万,十年前,这个数字是 490。Auto research 渗透到了科研的各个环节,极大缩短了工作的完成周期,顶会投稿数量也水涨船高。另一边,顶会审稿本身也被生成式 AI 渗透,审稿质量良莠不齐。
我们在年初就开始进行 auto research 的探索。春节期间,端到端 auto research 系统 FARS [2] 问世,全程直播自动化科研的全部流程,而最终产出的大部分工作都较为平庸。Agent 已具备将一份 proposal 转换成代码,并进行完整实验的能力,FARS 的一系列产出也证明了这个事情;而真正制约 auto research 质量的,是 agent 所产出 proposal 的质量。FARS 产出的大部分 proposal 都比较 trivial, 只是多个组件的简单拼接,其中也不乏很多实验执行失败的 proposal。如果 agent based 的 ideation 系统能够自主提出有价值、有创新性的 proposal,就能打通高质量 auto research 的最后一步。Proposal 是对一个 idea 的完整包装,包含完整的背景阐述、文献调研、假设提出、实验设计和预期结果等,是 ideation 系统的产物。因此,我们开始重点关注 agent 的 ideation 能力。
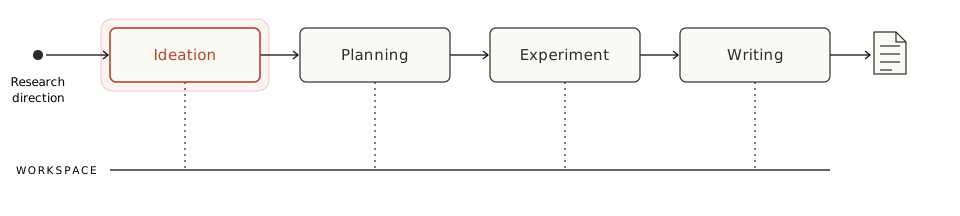
对一份 proposal 最好的评估,就是将其付诸实验并由其结果来判定。在一些场景中,这条路是走得通的。AlphaEvolve [3] 用 LLM 驱动程序的进化搜索,每个候选程序都由一个自动的 evaluator 打分,很快就能对每次迭代给出反馈;Anthropic 的 Automated Alignment Researcher [4] 研究 weak-to-strong supervision,一次微调实验不到两小时,agent 把预测结果提交给远程 API 就能直接拿到 PGR(performance gap recovered)分数;这类任务的共同点是 outcome-gradable:问题被事先定义好,有一个明确、可自动计算的指标,反馈周期以分钟或小时计,系统可以大量试错,直接朝着指标 hill-climb。
但我们关注的 auto research 不是这样的场景。它面对的是开放的研究问题,没有一个预先定义好的指标直接说明一个 idea 好不好;即使把 proposal 付诸实验,从写代码、跑实验到分析结果,完成周期也通常以周甚至月为单位,是一个非常典型的 long horizon 场景。一个 proposal 对领域的价值还要看 paper 发表之后的社区反应,这个反馈周期以年计。这样的时间成本是 ideation 的搜索过程无法承受的,并且一旦一个非常不可靠的 proposal 直接进入实验阶段,也会浪费大量的实验资源。因此一个能够在 ideation 阶段就对 proposal 进行评估的系统非常重要:它要在缺少直接反馈信号的情况下,提前做出判断,所以其本身也必须足够可信。
然而针对 proposal 的评估,一直是领域中尚不成熟的部分。最直接的做法是写一份 rubric,让 agent 按维度打分。FARS 的 ideation 模块正是这样做的:pipline 中的评审 agent 从 insight depth、importance、significance、soundness、feasibility 等 7 个维度给 proposal 打分,加权得到总分。评审 agent 的打分并没有依赖其他外部信号进行校准而全凭其自由发挥,结果是筛选出了一批平庸的 idea,这需要进一步完善,通过一些外部信号来校准这一过程。
Idea 的评估,或 idea 的选择,对人类研究者而言,涉及到研究品味 research taste 的判断。领域内已经有不少 benchmark 和 evaluator 尝试利用不同的信号对这一过程进行建模和评测,但都存在一定的局限性。
以真实论文为参照
这类工作的思路是让 ideation 系统去拟合一篇已经发表的论文:取一篇 target paper,将其发表前能拿到的 context 交给模型,如参考文献、研究背景和研究问题等,让模型生成 idea,再看生成的 idea 与目标论文有多接近。
- IdeaBench [5] 收集了 2,374 篇生物医学论文,把每篇论文 background 部分引用的参考文献摘要交给模型生成 idea,再用语义相似度和 LLM 打分衡量生成的 idea 与目标论文的重合程度。
- AI Idea Bench 2025 [6] 把范围换到 AI 领域,选取 GPT-4o knowledge cutoff 之后发表的 3,495 篇顶会论文,为每篇挑出 5 篇最直接相关的参考文献作为输入,以 target paper 的 motivation 和实验计划作为 ground truth,用选择题、相似度打分等方式衡量对齐程度。
- ResearchBench [7](及其前身 MOOSE-Chem [8])把科学发现拆成三步:从候选论文中找出真正启发了目标工作的 inspiration,把研究背景和 inspiration 组合成假设,让 agent 在多个候选假设中选择出最符合 target paper 的那个。
这类方法的好处是 ground truth 可靠,构造容易规模化。但它衡量的其实是拟合 target paper 的能力,而不是提出好 idea 的能力,评测的能力偏了。同一个研究问题下值得做的 idea 远不止被发表的那一个,若 ideation 系统生成了一个与真实论文思路不同、但客观上同样有价值的 proposal,这套评测就失效了。
以人类专家标注为标签
另一个自然的做法就是直接由领域专家对 idea 进行评估,这类信号又可以分为两种。
第一种是请专家按设置的多个维度打分。最有代表性的是 Stanford Si 等人 [9] 的大规模人类专家实验:100 多位 NLP 研究者盲评人类专家与 LLM 写的 idea,结果 LLM 的 idea 在新颖性上得分显著更高。但同一项研究也暴露了这种信号本身的问题:评审之间的一致性只有 56.1%,低于 NeurIPS、ICLR 正式审稿的水平。
Anthropic 的 TASTE [10] 则把专家判断做成了一个 pairwise benchmark:用 Claude Opus 4.6 生成 AI safety 方向的研究 proposal,请 10 位 AI safety 研究者打分、两两讨论后再修正,最终筛出 92 对偏好明确的 proposal。我们的做法和这有类似之处,但在我们的工作周期中还尚未发表此篇工作,因而当时对这部分的理解还尚不深刻。
第二种是以会议的录用结果或审稿意见为标签。GraphEval [11] 用 ICLR 2021–2023 投稿的 abstract 和录用结果做训练和测试;InnoEval [12] 用 ICLR 2025 和 NeurIPS 2025 的论文,把任务设成 reject/accept 或 reject/poster/highlight 的分类,从 clarity、validity、novelty、feasibility、significance 五个维度做基于检索的评估;ScholarEval [13] 则从 ICLR 2025 和 eLife 的审稿意见中抽取针对 idea 本身的评价,整理成 rubric,看系统给出的评价能否覆盖专家指出的要点。这类信号比招募专家打分更容易获得,也更接近真实的同行评议。但录用与否其实混杂了写作质量、实验完成度、审稿人匹配、投稿时机等太多噪声因素,与一个 idea 本身的价值仍有不小的 gap。
以单一可验证维度为标准
这一类工作不再对 idea 做整体判断:
- 只评 novelty。Literature-Grounded Novelty Assessment [14] 先检索与 idea 最相关的文献,再按 purpose、mechanism、evaluation 等核心 facet 重排;只要 idea 在至少一个 facet 上与所有检索到的论文都不同,就判为 novel。
- 只评实验结果。Forecasting Research Success [15] 从 Papers with Code 的 leaderboard 出发,构造了一万多对 idea,让模型预测在同一个 benchmark 上哪个 idea 的结果更好。
- 只评真实性或解释力。TruthHypo [16] 在生物医学知识图谱上按时间切分,检查模型基于旧知识提出的假设能否被后来的文献证实,并以假设能否被已有文献和知识图谱支撑作为其 groundedness;HypoBench [17] 则看生成的 hypothesis 能否解释给定的观测数据,在合成数据上直接与真实的数据生成机制比对。
这些评测在各自的维度上客观得多,结果也能被直接检验。但一个 idea 的价值从来不只由新颖性或提点决定:一个 novel 的 idea 可能毫无意义,一个能在 benchmark 上提点的 idea 也可能只是又一个工程 trick,这也恰恰是 FARS 产出的典型问题。并且它们评的往往是一个假设或一个方法,而不是一份包含问题定义、实验设计和预期结果的完整 proposal。
以社区的后续反馈为标签
这一类工作以后续社区反馈为标签来评估 idea 的价值。
- Proof of Time [18] 把评估设计成一个时间上的预测问题:给 agent 某个时间点之前的证据快照,让它预测之后才的结果,比如 2025 年 ACL/NAACL/EMNLP 论文的引用高低和奖项等级、某位 prof 下一年的研究方向以及某个 benchmark 未来的性能区间。
- AI Can Learn Scientific Taste [19] 把 scientific taste 定义为判断和提出具有长期影响力的 idea 的能力,并提出 RLCF(Reinforcement Learning from Community Feedback)。它从 210 万篇 arXiv paper 中构造了约 72 万对同领域、同时期的论文,以引用高低为标签,并训练 Scientific Judge 判断两篇 paper 中的更高引用者;再以 Scientific Judge 为 reward model,训练 Scientific Thinker 根据一篇 seed paper提出 follow-up idea 的能力。
但是这两个工作距离 ideation 场景的实际评测落地还有距离。AI Can Learn Scientific Taste 的评估对象是 paper 的 title 和 abstract,而这往往已经包含了实验结果和结论,这与 ideation 阶段的 proposal 不是同一种对象,但其使用的社区反馈信号对我们的工作具有启发意义。正如前文所言,一份 proposal 的真实价值本身由其实验结果和后续的社会反馈决定,而获取这种反馈信号的时间周期和成本是不可接受的。是否可以将在 ideation 阶段对 proposal 的评估和后续的社区反馈信号对齐?若能实现,则我们可以在 ideation 阶段就对 proposal 进行可信的评估,并决定资源分配和优化方向。这正是我们这个工作的探索方向和理想图景。
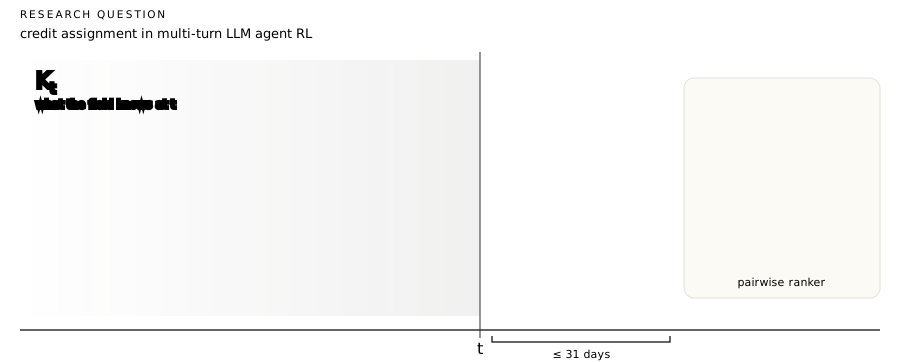
一个 idea 基于一个 research question 提出,其价值一方面应该是取决于被提出的那一刻,该领域已有的 knowledge base,另一方面取决于被做出来后,后来的工作怎样因之而影响。一个 idea 被提出的时间节点至关重要,针对同样的 research question,不同时间节点下,领域的 knowledge base 是不同的。形式化表示下,我们记 t 时刻的领域 knowledge base 为 $K_t$,记一个 idea 的 hypothesis 为 $H$,则我们将一个 idea 的价值形式化表示为 $V(H, K_t)$,表示其预期能为未来的 knowledge base 带来多少增量。我们认为其应当有如下的含义:
- $V(H, K_t)$ 是基于 $K_t$ 的一个预测的增量价值,一份 proposal 本身的真正价值,要由其被执行、被社区接纳后才能显现。
- $V(H, K_t)$ 的评估和预测,应该通过社区反馈信号进行对齐:历史上哪些 idea 后来被社区采用、被继承、被反复比较,以此来对齐 idea 价值评估的模式。
- $V(H, K_t)$ 应当是一个相对的价值比较,而不是一个绝对分数。本身并没有一个很好的客观标签能够衡量一个 idea 的价值,并且很难直接校准。与之相比,相对价值的比较是一个更简单的任务。这点和我们所设想的 ideation 系统形式也一致,ideation 系统可能一次产出多个 proposal,只要在同一个 research question 的 $K_t$ 下,比较这些 proposal 的相对价值并反复迭代这一“生成-评估-修缮”的 loop,理论上能逐渐逼近一个最优的 idea。
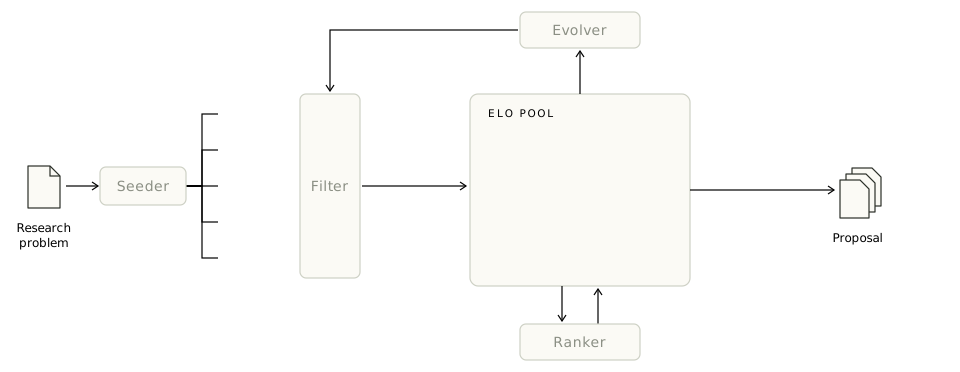
历史本身就是一个迟到的评估者,如果能在 ideation 阶段就提前对 proposal 进行评估将具有重要意义。我们期望能够通过历史社区反馈信号,以及将历史 paper 还原成 proposal 的形式,去探索对 idea 评估的模式。我们通过历史的 paper 数据和相关可用信号,不断地进行回测和尝试,最终设计出了期望的 idea 评估模式,并据此构造出 idea 评估的 benchmark。我们期望通过这个 benchmark,一方面能够用于优化 idea 评估系统本身,另一方面能够用于评估 ideation 系统生成的 proposal,从而选择出更有价值的 proposal。
chapter 2
我们首先思考如下的几个问题:idea 的评估形式应当是怎样的?怎样构造 benchmark?用什么历史信号来作为 idea 评估的标准?
idea 的评估形式应当是怎样的?
$V(H, K_t)$ 是一个相对的价值比较,且应当限定在相同的 $K_t$ 下。我们假设人类研究社区中,研究同一个 research question 并且在同一个时间周期内产出 paper 所基于的 $K_t$ 是相同的,因此基于这些 paper 所还原出的 proposal 将具备可比性。若 ideation 系统也基于同样的 research question 及其 $K_t$ 产出 proposal,则这和真实的人类研究者的 proposal 也具备可比性。这就是我们所期望的 idea 评估模式。因此 benchmark 构造上,目标是找出足够多共享同一 $K_t$ 的一批 paper。这一模式中,idea 评估系统需要能够在相同的 $K_t$ 下,对两份 proposal 给出一个可信的相对评价,我们认为应该能够借助历史社区反馈信号对齐来这一评价过程。
怎样构造 benchmark?
怎么找到足够多共享同一个 $K_t$ 的 proposal 集合?在构造 benchmark 上,我们主要考虑的问题是:用什么数据,怎样规模化地找 $K_t$,以及怎样把 paper 还原成 proposal。
数据选择其实和 idea 评估系统息息相关。在 4 月份,我们预计会使用 GPT-5.4 或 Opus 4.6 作为 idea 评估系统的 base model,那所选择的历史 paper 数据的周期必须在 base model 的 knowledge cutoff 之后,以防止模型可能在训练数据中见过这批 paper 从而造成污染。GPT-5.4 的 knowledge cutoff 是 2025 年 8 月 31 日 [20],而 Opus 4.6 的 training date cutoff 是 2025 年的 8 月 [21],因而使用 arXiv 上 2025 年 9 月至 2026 年 1 月的 AI 相关论文(cs.LG、cs.AI、cs.CL、cs.CV、stat.ML)作为数据来源。
在剔除 survey、纯 benchmark 以及纯数据集等不以研究假设为核心的 paper 后,我们得到了 35,505 篇 paper。我们需要在这 35,505 篇 paper 中,找到足够多的 research question,然后再限定时间条件来构造出一批 $K_t$。一个自然的思路就是对 paper 依据 research question 进行聚类。
最初我们尝试给每篇 paper 抽取 topic、subtopic、contribution type、target object、task、method family、used benchmark 等标签,然后按标签的重叠程度分给不同的 cluster。但我们发现不少标签高度重合但实际并不符合语义要求的 paper 对,比如 SimpleTIR: End-to-End RL for Multi-Turn Tool-Integrated Reasoning [22] 和 Inpainting-Guided Policy Optimization for Diffusion LLMs [23],两篇 paper 的标签几乎完全重合,都是强化学习、都做推理、都在数学 benchmark 上评测,但一篇研究工具调用的多轮 RL,另一篇研究扩散语言模型的策略优化,显然并不在研究同样的 research question。此外,有另一个问题也应该讨论,research question 的粒度如何定义?在这次聚类中,不同 cluster 之间的粒度存在较大的不均匀性,LLM、RL 等是粒度非常宽泛的 research question,再比如 GUI Agent 粒度也较宽泛,而 diffusion 加速采样则粒度较细;此外,不同 cluster 之间有一定程度的重叠,比如 “LLM Safety and Robustness” 和 “Adversarial Robustness and Defense”。我们最终认为,不该从粒度规则出发,因为本身很难依靠自然语言去约束筛选的粒度规则,而应该反过来,以最终每个 cluster 的大小区间作为 research question 的粒度。我们认为 cluster size 本身就是对粒度的一种操作性定义,并不通过粒度的语义属性,而直接通过其结果属性进行约束。
具体实现上,我们参考了 TaxoAdapt [24] 的树状聚类方式。我们以每篇 paper 的 title, research problem, task formulation, used benchmark 作为聚类特征,逐层树状聚类,直到每个叶子节点都落在 [10, 50] 的 size 内。在树的一级、二级标签生成之后,为了防止在大方向上依然出现 research question 的重合,因而会进行人工去重;此外,在分配 paper 至标签节点时,我们允许一篇论文同时属于 1 到 3 个节点。最终,35,505 篇论文被组织成一棵 6 层的树,包含 1,799 个叶子节点。最后为每个叶子节点归纳 research question,并逐篇检查每个叶子节点并剔除不相关的 paper,这一过程剔除了 4,357 篇 paper。
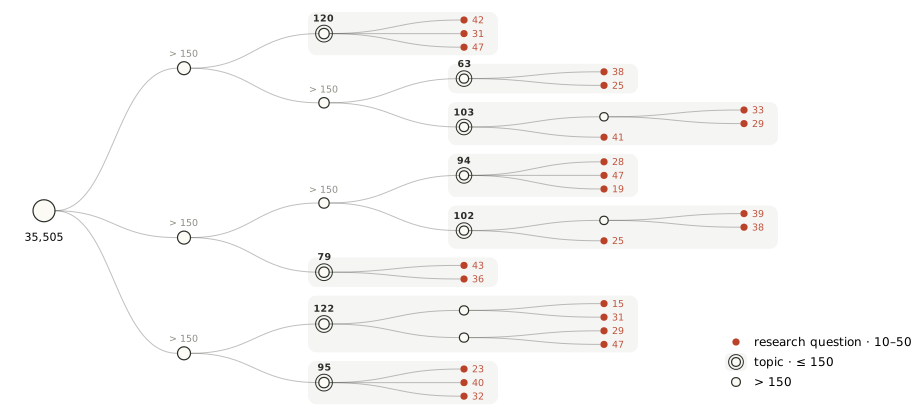
$K_t$ 还要求时间相同。我们在聚类树上取子树总论文数不超过 150 的节点作为大的 topic cluster,再在每个 topic cluster 内按 31 天的时间窗口将 paper 切分成不同的 cohort。一个 cohort,就是对"同一个 $K_t$“的近似:同一个 research question、同一个月内发表的一组论文。之所以在大的 topic cluster 而不是叶子节点上切分,是因为叶子节点平均论文数较少,再按时间窗口切开,每个窗口里剩下的论文太少,构不成有意义的比较。
时间维度还带来了一个容易被忽略的问题:date leak。有些 paper 在挂上 arXiv 之前,已经以期刊、OpenReview 投稿等形式公开过,其真实公开早于 arXiv 日期。因而我们对所有论文做了一次全量的 date leak 检查,剔除了有问题的论文,调整了其真实的公开日期。
最后一步,是将 paper 还原成 proposal。我们设计了一个 paper-to-proposal 的 pipline,我们期望还原的 proposal 保有完整的文献调研,方法设计,以及实验设计和预计效果。转换过程遵循两条原则:不泄漏结果,以及忠实于 paper 本身的研究计划。将 paper 主结果表中提出方法的所有数字都替换为 TBD;和哪些 baseline 比较、做哪些消融、在哪些数据集上评测,属于实验设计部分,应该完整保留。转换后的 proposal 统一为固定的结构:Introduction(包括核心洞见、可证伪的假设,以及"方案潜在的失败模式”)、Proposed Approach、Related Work、Experiments、Success Criteria、Impact Statement 和 References。我们之后设计的 ideation baseline 也按照同样的结构产出 proposal,因而具有可比性。
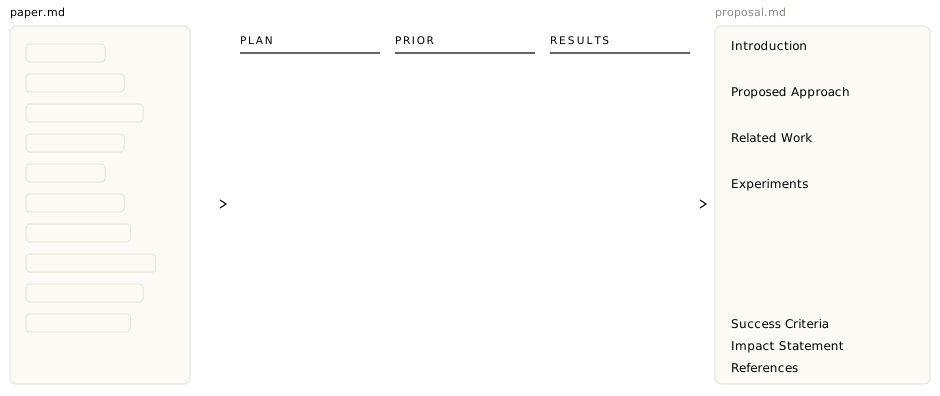
此外,在同一套聚类之上,我们最终构造了两个用途不同的 benchmark。
Ideation benchmark 用来评测 ideation 系统。我们从聚类树中人工挑选了 70 个具有一定领域热度的 topic,按 31 天的时间周期切分出 cohort。为了保证 cohort 内的 paper 质量,我们剔除了 cohort 中 citation count 为 0 的 paper,最终保留论文数不少于 10 篇的 cohort。最终的 ideation benchmark 包含 91 个 cohort,覆盖 40 个 topic。这里的 topic 即为 $K$,近似认为一个 cohort 中的 paper 都研究同一个 research question 且共享相同的 $K_t$。每个 cohort 中 paper 的最早公开日期的前一天作为 $t$。评测时,ideation 系统拿到一个 cohort 的研究方向和 cutoff 日期,生成一份 proposal,再看它能打败 cohort 中多少份人类 proposal。
Calibration benchmark 用来校准 idea 评估系统本身:既然要让 idea 评估系统去评 AI 的 proposal,就得先确认它在人类 proposal 的历史数据上是否能判断得准。它由同一 topic 内、发表时间相差不超过 31 天的 paper 两两配对构成;我们还让其在 topic 分布上尽量贴近 ideation benchmark:最初版本构造了 260 对 pair,覆盖了 ideation benchmark 40 个 topic 中的 37 个。至于 which one is better 的偏序标签从哪里来,留待下节阐述。
用什么历史信号来作为 idea 评估的标准?
什么信号是衡量 idea 的 gold standard?我们真正期望评估的是一个 idea 对领域 knowledge base 的增量价值,这并没有办法直接观测。可用的历史社区反馈本身都是针对 paper 质量的衡量,这实际上和 idea 本身已经存在偏差,因此只能找一些间接的信号来作为标准。我们思考过使用会议评审的分数作为标准,但这存在问题。本身会议审稿质量存在较大差异,不同审稿人之间的标准并不一致,且可使用的公开数据量较少。与之相比,paper 的引用量 citation count 是一个更客观的信号。
尽管 citation count 也存在噪声,依然受到学术机构、研究者声誉等因素的影响,但我们认为,在同一 research question 下、同一时期内比较 paper 的长期引用量(发表后 12 到 18 个月),是目前能拿到的最接近 idea 之间价值差异的客观信号。领域热度、发表时机、社区关注度这些主要的混淆因素,在限定研究领域以及相同时间周期的情况下会被抵消掉相当一部分;剩下的差异,更多反映的是谁的方法被别人采用了、谁的问题定义被继承了、谁的结果被反复拿来比较,这些更接近 idea 的真实价值。
但这里存在一个矛盾。前文提到为了避免 base model 在训练数据中见过这批 paper,我们只能使用 2025 年 9 月之后的论文;而在我们拉取引用数据的 2026 年 5 月,这些 paper 才发表了 4 到 8 个月不等,远没有积累出长期引用。标签的可信需要时间,评测的有效却要求 paper 足够新。我们不可能等一年之后再来做评测,届时新模型的 knowledge cutoff 又会把这批 paper 覆盖掉。能否在引用窗口还相当初期之时,就还原出 paper 之间与长期引用一致的价值偏序关系?
我们最初的直觉是:短期引用的噪声可能可以从 citation count 的语义角度进行修正。一篇 paper 被别人采用了方法、被拿来做对比实验、被在其基础上扩展,显然比在 related work 里被一笔带过更有分量。于是我们对引用发生的上下文做了分类,并尝试赋予不同的权重,例如 Background 0.5、Comparison 1、Use 1.5、Extension 1.5;我们进行了一定的尝试,但最终这个方式也存在很多限制。学术领域的数据基建并不完善,semantic scholar 有 api [25] 能够提供一篇 paper 被其他工作引用的上下文信息,但存在较多的数据空白,对修正质量造成较大影响。我们尝试了一些建模方式也最终无果。
我们再次回到原始的 citation count。我们期望探索,在引用窗口还很早的时候,是否在某些限定条件下 paper 的引用偏序已经足够可信呢?为此我们做了一次回测。取 2024 年 1 至 5 月的 29,135 篇 AI 方向 arXiv paper,用与 benchmark 完全相同的方式聚类,再在每个聚类内按发表月份切出 cohort。分别统计每个 cohort 中 paper 在发表后 4 到 8 个月的引用数,这正是 benchmark 中 paper 在我们拉取引用数据时的实际引用积累周期,然后在每个 cohort 内为 paper 两两配对。在每个观察窗口下 (比如发表后 4 个月,5 个月… 直至 8 个月),我们用当时的引用数在同一对 pair 内排序,再看这个排序与 12 个月后的排序是否一致。
最终的结论是,当两篇 paper 的 citation count同时满足以下两个条件时,其引用偏序已经足够可信:
$$|c_a - c_b| \ge 4 \quad \text{且} \quad |\log(1+c_a) - \log(1+c_b)| \ge 0.5$$前者是引用量的绝对差距,保证差距不是一两次偶然的引用造成的;后者是相对差距,保证差距相对于基数足够大。只看对数差距,会把 0 次对 1 次、1 次对 3 次这样的 pair 也放进来,它们的相对差距看上去很大,实际上只差一两次偶然的引用;只看绝对差距,又会放进 40 次对 44 次这样相对差距很小的 pair。两个条件同时满足时,可靠性最高,而覆盖率几乎没有损失。以 4 个月的窗口为例:
| Filtering rule | Coverage | Agreement with 12-month ranking | Ranking flip rate |
|---|---|---|---|
| Absolute gap only, $d \ge 4$ | 37.9% | 96.9% | 2.5% |
| Log gap only, $\text{log\_gap} \ge 0.5$ | 63.2% | 93.1% | 5.4% |
| Both | 37.2% | 97.3% | 2.1% |
在整个 4 到 8 个月的区间里,这条规则的表现如下:
| Observation window | Pairs selected | Coverage | Agreement with 12-month ranking | Ranking flip rate |
|---|---|---|---|---|
| 4 months | 2,910 | 37.2% | 97.3% | 2.1% |
| 5 months | 4,439 | 42.3% | 97.8% | 1.6% |
| 6 months | 5,897 | 45.7% | 98.3% | 1.2% |
| 7 months | 7,248 | 47.9% | 99.0% | 0.7% |
| 8 months | 8,667 | 49.9% | 99.4% | 0.3% |
因此我们认为,在同一个 cohort 内,满足上述两条规则的 paper 对,其本身的 citation count 能够成为 which one is better 的代理信号。我们筛选的 calibration benchmark 中的 pair 正是基于这个规则。
chapter 3
有了 benchmark 以及可用的对齐信号后,接下来构造 idea 评估系统,需要验证其在历史数据上的一致性并基于此进行优化。
在我们设计的评估模式中,idea 评估系统实质上是一个 pairwise ranker。给定两份 proposal 和一个 cutoff 日期 $t$,ranker 需要判断,在相同的 $K_t$ 下,哪一份 proposal 的 $V(H, K_t)$ 更大。我们使用 GPT-5.4 和 Opus 4.6 作为 ranker 的 base model,并且设计了一套 rubric 作为评价的依据。
我们最初设计的 ranker 架构由三部分组成:
- Literature Review Agent:在 cutoff 之前的文献中,对这对 proposal 共同的研究方向做一次全面的调研,产出一份 literature review,作为可复用的 $K_t$;
- Parallel Analysis Agent:在 literature review 的基础上,各自针对两份 proposal 做增量的检索,产出两份 analysis report,分别分析两份 proposal 在 $K_t$ 下的增量价值;
- Judge Agent:阅读 literature review 和两份 analysis report,并基于我们设计的 rubric,给出最终判断。
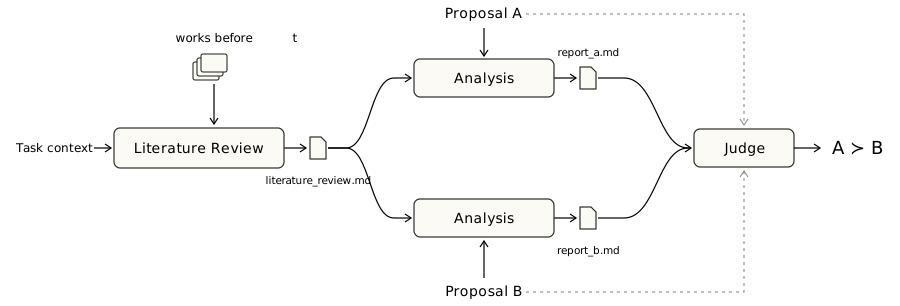
这里的 rubric 是我们对 Judge Agent 的优化方式,是一种 prompt 技巧。我们期望 Judge Agent 能够在 rubric 的指引下和 calibration benchmark 中的 pair 进行对齐,从而具备真实评测的可用性。
rubric 的设计围绕 $V(H, K_t)$ 的定义出发。我们将其定义为:在 $K_t$ 下推进一个 idea,能为未来的 knowledge base 带来的期望增量,:
$$V(H, K_t) = \mathbb{E}[\Delta K \mid H, K_t]$$这个期望既包含 proposal 本身的价值,也包含其被实现的概率。据此,rubric 要求 ranker 在以下几个因子上进行两两比较:
- Demand:研究社区是否关注这个问题;
- Marginal Contribution:相对于已被社区吸收的工作,增量贡献有多少;
- Realization Probability:它的核心主张有多大可能被真正做出来;
- Informative-Negative Value:即便假设不成立,失败的结果是否仍然具有启发意义;
- Adoptability:如果成功,后续的工作能否使用或扩展它;
- Experimental Credibility:它的实验设计能否产生让社区信服的证据;
- Cost or Risk:它所需要的资源和承担的风险是否可控。
这几个因素不是可以相互补偿的打分项,而是一个 idea 产生价值所必须依次经过的环节,任何一项接近零,其带来的领域增量价值 $\Delta K$ 也接近于零,一个维度的高分无法掩盖另一个维度的致命缺陷:重复已有工作意味着增量为零,站不住的前提意味着结果无法实现,薄弱的实验设计意味着拿不出可信的证据。Ranker 在每个因子上两两对比 proposal,最后综合输出 A > B 或 A < B 的判断。
最初构造的 calibration benchmark 共 260 对 pair,我们从中切出 60 对作为 dev set,其余 200 对作为 test set 进行后续的校准实验,结果如下:
| Setting | Data | Accuracy |
|---|---|---|
| Random | dev | 50.0% |
| Always predict A < B | dev | 55.0% |
| Ranker (GPT-5.4) | dev | 78.3% |
| Ranker (GPT-5.4) | test | 76.0% / 75.5% / 74.5% |
按两篇 paper 的 citation gap 分桶,test set 上的准确率如下:
| Citation gap | 0–10 | 11–19 | 20–49 | 50+ |
|---|---|---|---|---|
| Pairs | 42 | 77 | 66 | 15 |
| Accuracy | 76.2% | 67.5% | 78.8% | 100% |
Citation count gap 在 50 以上的 pair 全部判对,这一定程度上和我们的预期一致,citation count gap 差距越大的 paper,其 proposal 的质量差异也越显著。
我们期望对 ranker 做更细致的分析,验证我们所设计的三个阶段是否真的有效,于是我们只保留最终的 judge agent,直接读取两份 proposal,跳过 literature review 和 analysis 阶段。为了验证不同 base model 是否具有一致的结果,我们在 GPT-5.4 和 Opus 4.6 上分别进行了实验,结果如下:
| Configuration | Accuracy |
|---|---|
| Three-stage ranker + GPT-5.4 | 75.5% |
| Judge Agent only + GPT-5.4 | 76.0% |
| Judge Agent only + Opus 4.6 | 76.0% |
其最终的准确率几乎一致,甚至只保留 judge agent 的准确率还略高,这个结果让我们产生怀疑。我们认为在没有提供统一且可信的 literature review 的情况下,judge agent 直接对两份 proposal 的评估应该是不可靠的,但实验结果却并没有反映这一点。一开始我们怀疑这是 calibration benchmark 的问题:260 对 pair 中不同月份的分布不均匀,大部分 pairs 的时间节点都集中在 25 年 9 月份,而我们所选用的 GPT-5.4 和 Opus 4.6 的 knowledge cutoff 都在 8 月,很可能本身就对这之前的领域知识有充分的认知。于是我们对 calibration benchmark 做了第一次调整,基于之前的筛选规则重新选取 pair,重建了一个时间节点分布更均衡的 250 对 pair 的 test set,但最终准确率竟然直接达到了 80% 以上。这更让我们疑惑,我们不得不开始怀疑是否由真实 paper 还原的 proposal 本身就带有明显的质量差异信号,使得 judge agent 仅仅依据 proposal 中的某些内容就能完成评估呢?为了弄清楚这一点,我们开始对 proposal 的各块章节内容进行消融,最极端的实验,我们甚至让 judge agent 只看两份 proposal 的标题。最终的结果更加匪夷所思:
| Input | GPT-5.4 | Opus 4.6 |
|---|---|---|
| Random | 50.8% | 50.8% |
| Titles only | 72.8% | 74.0% |
| Core hypothesis + method + experiments | 79.2% | 82.0% |
| Core hypothesis + method | 78.8% | 79.6% |
| Full proposal | 82.4% | 80.4% |
| Full proposal minus core hypothesis and method | 83.2% | 80.8% |
去掉 proposal 中的一些核心模块后,准确率也并没有出现明显的波动。我们分析了一些具体的 proposal,其 related work、experiment、impact、references 等章节确实一定程度上存在重叠,比如删去 proposal 中的核心假设,但其信息在 Introduction 和后续的实验章节其实也间接出现了。此外,我们猜测一份高质量的 proposal 本身已经描述了足够详细的领域知识,这可能是让 literaure review agent 无用的原因。
此外,只看两份 proposal 的标题,竟然也能够有 73% 左右的准确率。我们专门核查了 judge agent 的推理过程,它确实在围绕问题域和方法的可传播性做判断。比如 Monet: Reasoning in Latent Visual Space Beyond Image and Language [26] 和 CoCoVa: Chain of Continuous Vision-Language Thought for Latent Space Reasoning [27],judge 仅凭两个标题,就判断后者 “names a more concrete and citeable research object”,并且最终判断正确。这说明目前的 judge agent 很大程度上只是在做关于选题和传播性的判断:这个方向热不热,这个贡献好不好被引用,名字起得响不响,这和我们期望的 idea 评估目标并不一致。我们的 calibration benchmark 可以被一个只看标题的 judge agent 解决大半,说明其衡量的能力点和我们真实想测的 idea 评估能力存在差距。
与此同时,我们搭建出了一批 ideation baselines:给定 benchmark 中一个 cohort 的研究方向和 cutoff 日期,让 Claude Code 或 Codex 这样的 CLI agent,借助一组我们设计的、具有严格 cutoff 限制的文献检索工具,完成文献调研、gap 分析、假设提出、设计实验,最后产出一份 proposal。我们用 Opus 4.6、GPT-5.4、DeepSeek-V4-Pro、Kimi-K2.6、GLM-5.1 等模型在 ideation benchmark 的 91 个 cohort 上各跑了一遍,并直接使用基于 Opus 4.6 的 judge agent 进行评测,把每份 AI proposal 和同一 cohort 中的人类 proposal 逐一比较:
| Ideation system | Win rate vs. human proposals |
|---|---|
| GLM-5.1 + Claude Code | 78.8% |
| Opus 4.6 + Claude Code | 75.5% |
| DeepSeek-V4-Pro + Claude Code | 69.4% |
| GPT-5.4 + Codex | 54.6% |
| Kimi-K2.6 + Claude Code | 50.7% |
这一实验结果也并不可信,一方面是 judge agent 本身就存在问题,另一方面这里的胜率排序和 agent 能力的排序也并不一致。我们开始对一些结果做 case study,一个典型的例子是 DeepSeek V4 Pro,其在一个多轮 agent 强化学习 cohort 上生成的 proposal 是研究多轮交互中的信用分配问题的。它和 cohort 中的 13 篇人类 proposal 逐一比较,实现了 100% 的胜率。judge agent 给出的理由如下:它解决的是一个 “fundamental algorithmic problem”,是一个 “drop-in module”,“no auxiliary model”,可以被 GRPO/DAPO 的广大用户直接采用,因而会获得 “durable method citation”。但我们自己读下来,发现它的核心机制并不扎实。它把多条 rollout 中同一个 step index 下不同 rollout 的动作当作彼此的 counterfactual,以此估计每一步的 advantage。问题是,在多轮交互中走到第 k 步时,不同 rollout 的 observation history 早已分叉,它们根本不是同一个状态下的不同选择,这个比较并不构成 counterfactual。
我们认为这是由于 judge agent 对 propoasl 的可行性验证做的并不扎实,因此偏好一些看似具有诱惑力但实则不具备可行性的 proposal。而我们之前构造的 calibration benchmark,其中的 proposal 全部由人类研究者的真实 paper 改写而来,本身就具备高度的可行性,这是 calibration benchmark 和真实评测之间的分布偏差。
因此需要再对 calibration benchmark 的 pair 分布进行调整,再基于此对 judge agent 做校准。我们期望构造出这样的 human-AI pair:pair 中的一个 proposal 是由人类研究者真实 paper 改写,另一个 proposal 由 ideation 系统产生,这才和真实的评测需求一致。此外,需要存在一部分 ideation 系统产生的 proposal 存在明显的不可行或缺陷,以此来修正 judge agent 对 proposal 可行性的判断能力。
human-AI pair 没有 citation 可以作为 which one is better 的标签,只能人工标注。我们从 ideation baseline 中跑出的 proposal 入手,检查 AI proposal 是否已被已有工作抢先、是否存在幻觉、方法是否 sound、实验设计是否有缺陷,并标注严重程度并附上证据;然后再和 benchmark 中对应 cohort 中的 proposal 组成 pair。此外,确实存在少量质量较高的 AI proposal,我们也如实和人类 proposal 进行比较,并保留了少量 AI proposal 胜出的 pair。最终我们得到了 75 对标注好的 human-AI pair,其中 18 对 pair 中 AI proposal 胜出,57 对 pair 中人类 proposal 胜出,且后者中的大部分 AI proposal 标注了显著的缺陷。
我们简单修改了 judge agent 使其和我们的标注过程一致,让其对 proposal 的缺陷也进行识别,并判断缺陷的严重程度,然后再做综合判断。在这 75 对 human-AI pair 上做评测,judge agent 的准确率只有 49.3%,只接近随机结果。
| Label | Pairs | Accuracy |
|---|---|---|
| AI proposal better | 18 | 83% |
| Human proposal better | 57 | 39% |
| Overall | 75 | 49.3% |
我们统计了它对缺陷识别的情况。在所有判错的 pair 中,judge agent 没有一次把 AI proposal 判为致命缺陷。即便把范围扩大到全部 75 对,在标注者认定 AI proposal 存在致命缺陷的 15 对 pair 中,judge agent 也只在其中 8 对上识别成功。
翻看具体的 case,我们发现 judge agent 往往读到了缺陷位置,但没有验证。甚至有时 judge agent 已经识别出了标注者所指出的风险,最终依然判 AI 胜出:它依然更偏好 AI proposal 中完整、漂亮的实验计划,也会将 AI proposal 站不住的脚的宽泛假设收窄成一个仍然可行的版本,却不给人类 proposal 同样的宽容。
针对这些问题,我们对 rubric 再做了几轮调整:先审核 proposal 的核心主张,再判断 soundness 和可行性,再检查已有工作,最后才综合评估影响力,但实验结果依然没有改善。最后,我们强制修改 judge agent 的判断流程,让其对 proposal 中每一个公式和关键信号动手验证,必要时写代码跑一个最小的例子。这个机制一定程度上确实生效了,judge agent 开始做维度检查、逐行验证推导,并能够识别出一些标注的缺陷,但最终的实验准确率依然没有起色。我们也尝试了更换 base model,甚至也尝试去使用 knowledge cutoff 不符合要求的 GPT-5.5:
| Judge Agent | Overall accuracy | AI-better subset | Human-better subset |
|---|---|---|---|
| GPT-5.4 (original rubric) | 49.3% | 83% | 39% |
| GPT-5.4 (restructured rubric) | 45% | 89% | 32% |
| Opus 4.6 (forced verification) | ~43% | 100% | 32% |
| GPT-5.5 (forced verification) | 45% | 67% | 39% |
之后的优化甚至都不如最开始的准确率。我们猜测可能是 AI proposal 被 ideation 系统包装得更新颖、高影响、宏大;而人类 proposal 则忠实地描述了一篇真实的、因而往往是增量的、扎堆的、工程化的 paper。而 judge agent 的任务,恰恰是预测影响力、新颖性和被引用的可能性,或许 ideation 系统在这些方面更具优势。此外,human-AI pair 的标注由我们团队人工完成,不同标注者直接的标注质量可能也存在差异,我们也缺乏足够多的人力再去进行交叉验证。总之,无论是调整 rubric 还是更换模型,都不再有明显的收益,且此时恰逢一些外部因素,我们的项目停滞在了这里,没有再进一步探索下去。
chapter 4
在这个项目周期中,我们尝试对 idea 的评估进行系统性的建模,但最终 judge agent 的判断逻辑与我们的建模目标似乎始终无法校准到一致。我们的 paper 几乎已经写好,只差填入最后对 ideation 系统的评估数据,但由于 judge agent 本身评测的不准确,我们怎样也无法得到可信的结果。
回头看设计本身,我们的这套评估模式本身确实存在一些局限:
- 并没有找到一个完美的 idea 价值的代理信号。 citation 同时反映了 topic 热度、作者知名度、研究机构、代码是否开源、benchmark 是否被广泛采用等诸多因素;human-AI pair 的标签则取决于人工标注的质量。
- paper-to-proposal 的转换不可避免地带有后见之明。 即便删去了所有实验结果,还原出的 proposal 依然会继承成品 paper 的结构、叙事和实验选择,因而比之一份真正写在实验之前的 proposal 会更加连贯且保守。
- 偏序比较会放大 judge agent 的系统性偏好。 当两份 proposal 的真实价值相差不大时,judge agent 的选择往往取决于它的偏好:更优美的文本风格、更熟悉的方法等,且这一点难以消除。
此外不得不说的是,这个问题从一开始也被我们考虑得太大了,其中的很多失败模式都变得难以诊断和验证,因为混杂了太多的噪声。当 judge agent 判错时,我们很难分清问题出在标签、出在 paper-to-proposal 的转换、出在 rubric、出在检索,还是出在模型本身的能力上。每一个环节都可能是原因,而很难去做到可控的分析和调整,看不到清晰的因果。
在文章开始前,我们提到过那些"以单一可验证维度为标准"的工作:只评 novelty,或者只预测实验提点,认为它们评的不是一份完整的 proposal。但这种取舍或许恰恰是它们能拿到可信结果的原因,能够有更干净的校验信号和更清晰的失败模式。但我们依然认为评估一个 idea 的完整价值是一个值得追求的目标,这也有系列工作在尝试,但或许需要被拆成一系列更小、可以被单独验证的问题,一步步地去逼近最终的价值。
- Reviewer3. ICLR Went From 490 Submissions to 62,000 in Ten Years. 2026. https://reviewer3.com/evidence/iclr-submissions-2027
- Qiong Tang, Tianxiang Sun, Xiangkun Hu, et al. FARS: A Fully Automated Research System Deployed at Scale. arXiv:2606.31651, 2026. https://arxiv.org/abs/2606.31651
- Alexander Novikov, Ngân Vũ, Marvin Eisenberger, et al. AlphaEvolve: A Coding Agent for Scientific and Algorithmic Discovery. arXiv:2506.13131, 2025. https://arxiv.org/abs/2506.13131
- Jiaxin Wen, Liang Qiu, Joe Benton, Jan Hendrik Kirchner, Jan Leike. Automated Weak-to-Strong Researcher. Anthropic Alignment Science Blog, 2026. https://alignment.anthropic.com/2026/automated-w2s-researcher/
- Sikun Guo, Amir Hassan Shariatmadari, Guangzhi Xiong, et al. IdeaBench: Benchmarking Large Language Models for Research Idea Generation. KDD 2025. https://arxiv.org/abs/2411.02429
- Yansheng Qiu, Haoquan Zhang, Zhaopan Xu, et al. AI Idea Bench 2025: AI Research Idea Generation Benchmark. arXiv:2504.14191, 2025. https://arxiv.org/abs/2504.14191
- Yujie Liu, Zonglin Yang, Tong Xie, et al. ResearchBench: Benchmarking LLMs in Scientific Discovery via Inspiration-Based Task Decomposition. Findings of ACL 2026. https://arxiv.org/abs/2503.21248
- Zonglin Yang, Wanhao Liu, Ben Gao, et al. MOOSE-Chem: Large Language Models for Rediscovering Unseen Chemistry Scientific Hypotheses. ICLR 2025. https://arxiv.org/abs/2410.07076
- Chenglei Si, Diyi Yang, Tatsunori Hashimoto. Can LLMs Generate Novel Research Ideas? A Large-Scale Human Study with 100+ NLP Researchers. ICLR 2025. https://arxiv.org/abs/2409.04109
- Hasan Baig, Hailey Joren, Joe Benton. TASTE: Can AI Models Judge AI Safety Research Proposals? Anthropic Alignment Science Blog, 2026. https://alignment.anthropic.com/2026/taste/
- Tao Feng, Yihang Sun, Jiaxuan You. GraphEval: A Lightweight Graph-Based LLM Framework for Idea Evaluation. ICLR 2025. https://arxiv.org/abs/2503.12600
- Shuofei Qiao, Yunxiang Wei, Xuehai Wang, et al. InnoEval: On Research Idea Evaluation as a Knowledge-Grounded, Multi-Perspective Reasoning Problem. ICML 2026. https://arxiv.org/abs/2602.14367
- Hanane Nour Moussa, Patrick Queiroz Da Silva, Daniel Adu-Ampratwum, et al. ScholarEval: Research Idea Evaluation Grounded in Literature. arXiv:2510.16234, 2025. https://arxiv.org/abs/2510.16234
- Simra Shahid, Marissa Radensky, Raymond Fok, et al. Literature-Grounded Novelty Assessment of Scientific Ideas. SDP Workshop 2025. https://arxiv.org/abs/2506.22026
- Srujan P Mule, Aniketh Garikaparthi, Manasi Patwardhan. Teaching Language Models to Forecast Research Success Through Comparative Idea Evaluation. Findings of ACL 2026. https://arxiv.org/abs/2605.21491
- Guangzhi Xiong, Eric Xie, Corey Williams, et al. Toward Reliable Scientific Hypothesis Generation: Evaluating Truthfulness and Hallucination in Large Language Models. IJCAI 2025. https://arxiv.org/abs/2505.14599
- Haokun Liu, Sicong Huang, Jingyu Hu, Yangqiaoyu Zhou, Chenhao Tan. HypoBench: Towards Systematic and Principled Benchmarking for Hypothesis Generation. arXiv:2504.11524, 2025. https://arxiv.org/abs/2504.11524
- Bingyang Ye, Shan Chen, Jingxuan Tu, et al. Proof of Time: A Benchmark for Evaluating Scientific Idea Judgments. arXiv:2601.07606, 2026. https://arxiv.org/abs/2601.07606
- Jingqi Tong, Mingzhe Li, Hangcheng Li, et al. AI Can Learn Scientific Taste. arXiv:2603.14473, 2026. https://arxiv.org/abs/2603.14473
- OpenAI. GPT-5.4. OpenAI API documentation. https://developers.openai.com/api/docs/models/gpt-5.4
- Anthropic. Claude Opus 4.6. Claude API documentation. https://platform.claude.com/docs/en/models/opus-4-6/overview
- Zhenghai Xue, Longtao Zheng, Qian Liu, et al. SimpleTIR: End-to-End Reinforcement Learning for Multi-Turn Tool-Integrated Reasoning. arXiv:2509.02479, 2025. https://arxiv.org/abs/2509.02479
- Siyan Zhao, Mengchen Liu, Jing Huang, et al. Inpainting-Guided Policy Optimization for Diffusion Large Language Models. arXiv:2509.10396, 2025. https://arxiv.org/abs/2509.10396
- Priyanka Kargupta, Nan Zhang, Yunyi Zhang, et al. TaxoAdapt: Aligning LLM-Based Multidimensional Taxonomy Construction to Evolving Research Corpora. ACL 2025. https://arxiv.org/abs/2506.10737
- Semantic Scholar. Academic Graph API. https://api.semanticscholar.org/api-docs
- Qixun Wang, Yang Shi, Yifei Wang, et al. Monet: Reasoning in Latent Visual Space Beyond Images and Language. arXiv:2511.21395, 2025. https://arxiv.org/abs/2511.21395
- Jizheng Ma, Xiaofei Zhou, Yanlong Song, Han Yan. CoCoVa: Chain of Continuous Vision-Language Thought for Latent Space Reasoning. arXiv:2511.02360, 2025. https://arxiv.org/abs/2511.02360